Как распространять справочники в микросервисах: 4 способа
От хардкода до событий из мастер-системы
В сервисе компетенций семь грейдов сотрудников, а в сервисе найма пять. Кандидату предлагают оффер на грейд, которого в компании уже нет. Код при этом работает правильно. У каждого сервиса своя копия справочника, и копии разъехались.
Справочник грейдов нужен сразу нескольким сервисам, и сразу встаёт вопрос: где его хранить и как доставлять тем, кто им пользуется?
Чтобы ответить, нужно решить три задачи:
- Понять, что считать справочником, а что нет.
- Найти мастер-систему, которая им управляет.
- Выбрать способ доставки справочника потребителям.
Пойдём по порядку.
Что такое справочник
Справочник — это набор значений, на которые ссылаются другие данные: грейды, страны, валюты, языки. Такие данные в основном читают, меняют редко, и нужны они многим сервисам сразу.
Не справочник — данные, которые сервис создаёт в ходе своей работы: сотрудник, вакансия, заявка на найм. У них свой жизненный цикл, и они принадлежат одному сервису. Сотрудник ссылается на грейд «Senior», но сам сотрудник в справочник не входит.
Кто управляет справочником
У каждого справочника должен быть один хозяин — мастер-система. Только она создаёт, меняет и удаляет его элементы, остальные сервисы данные потребляют. Для разных справочников мастер-системы бывают разные.
Если хозяина не назначить, грейды начнут править в двух местах, и ты вернёшься к семи и пяти. Поэтому мастер-систему определяют до того, как выбирают способ доставки.
Четыре способа распространения
Мастер-система назначена. Теперь справочник надо доставить потребителям: хардкодом, библиотекой, через сервис справочников или событиями из мастер-системы. У каждого способа своя область применения и свои ограничения.
Способ 1. Хардкод в каждом сервисе
Самый простой вариант: каждый сервис держит справочник в своём коде. Он подходит для стабильных справочников, которые почти не меняются, например для языков интерфейса ru и en.
Ограничение: справочник живёт в каждом сервисе отдельно. Чтобы изменить значение, придётся пройти по всем репозиториям и выпустить релизы.
Способ 2. Библиотека
Справочник выносят в общую библиотеку, и сервисы подключают её как зависимость. Это тоже вариант для стабильных справочников, но хардкод уже не нужен: справочник контролируется в одном месте.
Ограничение здесь другое: объект элемента приходит из библиотеки, поэтому потребитель не может расширить его своими полями.
Пример: в библиотеке лежат страны с кодом и названием. Команде платежей нужна ещё валюта страны, но добавить её в чужой объект уже не получится. Остаётся либо тащить поле в общую библиотеку для всех, либо заводить рядом свою параллельную структуру.
Способ 3. Сервис справочников
Справочники выносят в отдельный сервис, к которому обращаются все остальные. Здесь есть два варианта.
Вариант 3.1 — синхронный вызов. Сервис найма во время своего use case идёт в сервис справочников за грейдами. Данные всегда свежие, но каждый найм теперь зависит от чужого сервиса: если тот лежит или тормозит, найм тоже встаёт.
Вариант 3.2 — периодический cron. По расписанию задача перекачивает справочник в базу потребителя. Сервис найма читает грейды из своей таблицы и может добавить к ним свои поля.
Вариант с cron лучше: он не создаёт прямой зависимости от внешнего сервиса во время выполнения use case. Но изменения доходят до потребителя только к следующему запуску, а между запусками копии расходятся.
Способ 4. События из мастер-системы
Самый надёжный способ — распространять справочник через события из первоисточника, то есть из мастер-системы.
Вернёмся к грейдам. Сервис компетенций отвечает за справочник «Грейды сотрудников» и за то, какие обязанности соответствуют каждому грейду. Сервису найма грейды тоже нужны: новый сотрудник получает грейд при найме.
Когда справочник меняется, сервис компетенций публикует событие «справочник изменён». Сервис найма получает его, забирает справочник и сохраняет у себя.
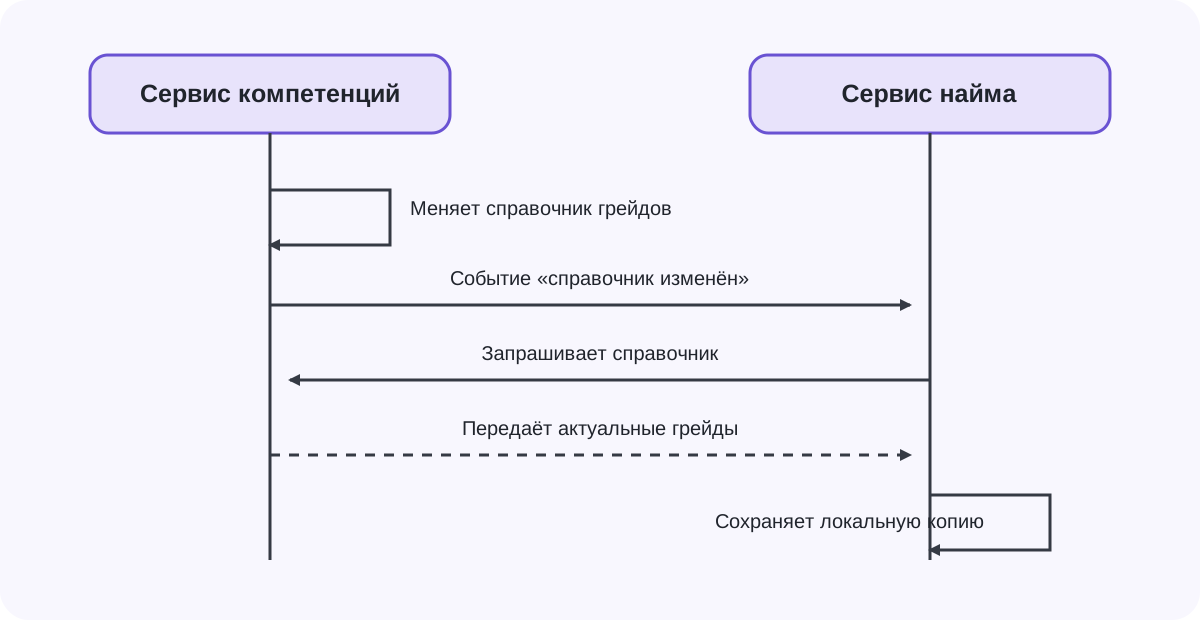
После события потребитель забирает актуальный справочник и обновляет локальную копию.
Обрати внимание: сервис найма обращается к сервису компетенций только после события, а сам найм работает с локальной копией.
Поэтому этот способ надёжнее остальных. Потребитель получает плюсы cron без его задержки: use case не зависит от доступности мастер-системы, у потребителя своя таблица со своими полями, а обновление приходит сразу после изменения, а не по расписанию.
Потребитель может забирать либо весь справочник целиком, либо только изменения. Это решение реализации.
Я предпочитаю забирать справочник целиком. Справочники обычно небольшие, а при загрузке только изменений легче что-то потерять: пропущенное или пришедшее не по порядку событие оставит копию неполной. Полная загрузка каждый раз приводит копию к состоянию мастер-системы.
Сравнение способов
| Способ | Для каких справочников | Единое место контроля | Свои поля у элементов | Зависимость от внешнего сервиса в use case |
|---|---|---|---|---|
| Хардкод | Стабильные | Нет, копия в каждом сервисе | Да | Нет |
| Библиотека | Стабильные | Да, библиотека | Нет | Нет |
| Сервис, синхронно | Изменяемые | Да, сервис справочников | Нет | Да |
| Сервис, cron | Изменяемые, с задержкой | Да, сервис справочников | Да | Нет |
| События из мастера | Изменяемые | Да, мастер-система | Да | Нет |
По таблице видно, что только события закрывают все четыре критерия для справочников, которые меняются.
Итог
Для стабильных справочников вроде языков хватит хардкода или библиотеки. Для изменяемых справочников, таких как грейды, лучше события из мастер-системы: у справочника один хозяин, потребители хранят свои копии и не зависят от него во время use case.
Как проектировать границы сервисов, события и интеграции между ними, разбираем на курсе по микросервисам.